ElevenLabsを日本語AIアプリに実装して分かったこと|v3・誤読・料金・クレジット消費を実測
ElevenLabsを実際の日本語AIアプリへAPI実装し、音質だけでは見えなかった誤読、イントネーション、速度、クレジット消費、UX設計まで検証しました。
※本記事にはElevenLabsのアフィリエイトリンクを含みます。リンク経由の申込みで当サイトに報酬が発生する場合があります。
先に結論
ElevenLabsは、日本語でもかなり自然な音声を作れるAI音声サービスです。ただし、実際のAIアプリに組み込んで継続利用すると、「音が自然かどうか」だけでは判断できません。
私が実際に日本語AIアプリへAPI実装して分かったのは、主に次の5点です。
- モデルによって自然さ・速度・安定性のバランスがかなり違う
- 日本語の誤読は、単語辞書だけでは完全には吸収できない
- 読みを直すとイントネーションが崩れることがある
- 常時生成ではクレジット消費が運用コストとして効いてくる
- 最終的には「いつ音声を生成するか」というUX設計まで見直す必要があった
つまりElevenLabsは、単純に「高品質なAI音声だから導入すれば終わり」というサービスではありません。一方で、用途とモデルを正しく選べば、日本語コンテンツ制作やアプリの音声体験を一段上げられる可能性は十分あります。
私がElevenLabsを使った用途
今回の検証は、単なるブラウザ上のText to Speech試用ではありません。
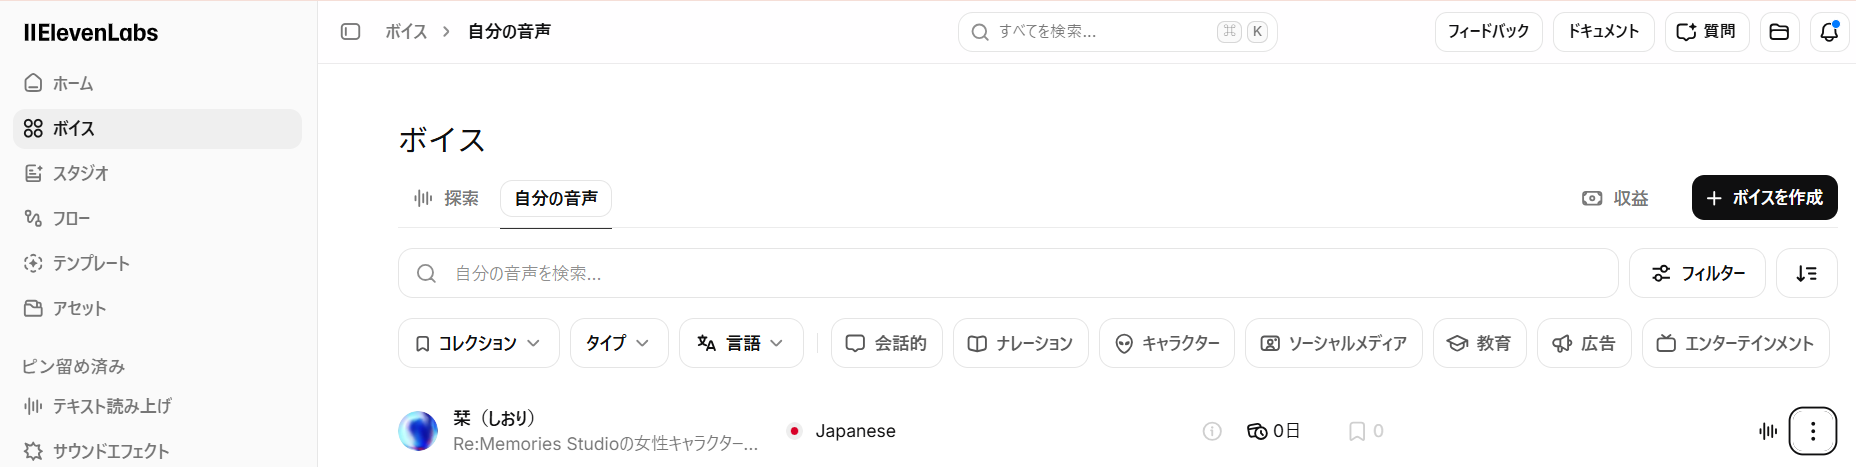
自作のWebアプリ「Re:Memories Studio」にElevenLabs APIを組み込み、AIが生成した日本語回答を音声で再生する用途で試しました。
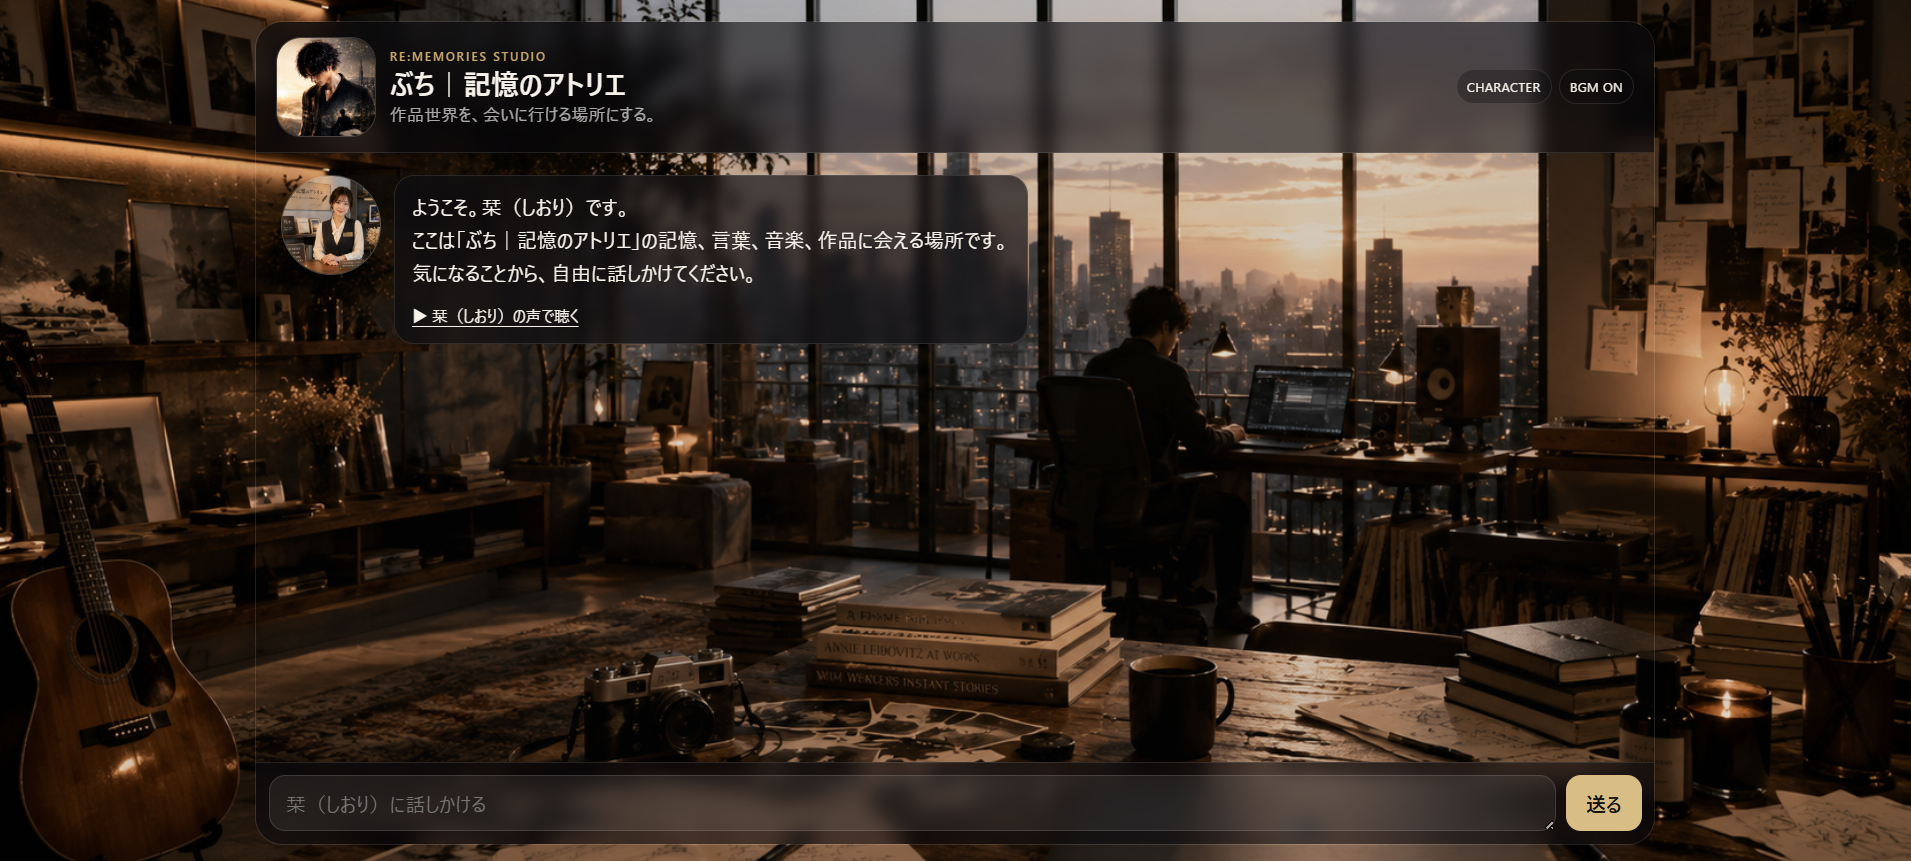
実際にElevenLabsを組み込んだ Re:Memories Studio を見る →
実装した体験には、回答後に「声で聞く」ボタンを表示し、押したときだけ音声生成・再生を行う仕組み、再生中はBGMを小さくし、終了後に元の音量へ戻す仕組みなども含まれます。
しかし実際に使い込むと、音質だけではなく、日本語の読み、イントネーション、応答速度、APIコスト、生成回数、そしてユーザーが本当に毎回答を音声で聞くのかまで考える必要が出てきました。ここが、単純なElevenLabsレビューと実装時の評価で最も違うところです。
ElevenLabsの主要TTSモデルはどう違う?
2026年9月時点で、ElevenLabsの主要なText to Speechモデルには、Eleven v3、Eleven Multilingual v2、Eleven Flash v2.5などがあります。
Eleven v3
Eleven v3は、感情表現や演技的な読み上げを重視する場合に魅力があります。公式では70以上の言語に対応し、オーディオタグによる感情・話し方の制御や複数話者の会話にも対応しています。
一方で、表現力が高い分、出力の一貫性やレイテンシーではFlash系より扱いにくい場面があります。私の用途のような「AI回答をすぐ聞く」体験では、表現力だけで選ぶとレスポンスとのバランスが悪くなる可能性があります。
Multilingual v2
Multilingual v2は、日本語を含む29言語をサポートし、長文生成で安定した品質を持つモデルとして案内されています。自然さを重視した日本語ナレーション、長文の読み上げ、コンテンツ制作では有力な選択肢です。
Flash v2.5
Flash v2.5は、公式上およそ75msの低レイテンシーを特徴とする高速モデルです。32言語に対応し、API生成ではMultilingual v2より文字単価を抑えやすい設計です。
AIチャット、音声エージェント、リアルタイム寄りのアプリでは速度が大きなメリットです。ただし、日本語では「速い=常に自然」とは限りません。私の検証では、速度だけでなく、固有の日本語表現や文章の読み方まで含めて確認する必要がありました。
一番大きかった問題は「日本語の誤読」
ElevenLabsを日本語で使っていて、最も工数がかかったのは誤読でした。
たとえば、アプリ内で扱う「生きた証」「想い」「動いています」「形にして」のように、日本人なら文脈で自然に読める表現が、期待した読みにならないことがありました。
一部は読みを調整することで改善しました。問題は、その対応を進めると別の語で誤読が発生したり、以前の方が自然だったイントネーションが崩れたりしたことです。
つまり、「誤読した単語を1つずつ辞書登録すれば終わる」という単純な問題ではありませんでした。文章全体の文脈、モデル、Voice、前後の語、読み補正の仕方が影響します。
日本語コンテンツでElevenLabsを本格運用するなら、「読み間違いゼロ」を前提にするより、重要語だけ補正し、多少の揺れを許容できる用途かどうかを先に考えた方が現実的です。
読みを直すと、イントネーションが悪くなることもある
誤読修正で意外だったのが、発音だけ直せば品質が上がるとは限らないことです。ある調整では問題だった語の読み自体は改善しましたが、その代わりに文章全体のイントネーションは以前の方が自然に感じられました。
音声品質には、正しい読み、自然なアクセント、文全体の抑揚、Voiceの個性、速度、感情が同時に関係します。「辞書で正しい発音にしたから完成」ではありません。日本語では特に、単語単体の正しさより、文章として違和感なく聞こえることの方が重要な場面があります。
クレジット消費は、アプリ実装では無視できない
ElevenLabsの料金は、単純な月額固定だけではありません。2026年9月時点のElevenCreative料金では、Freeは月10,000クレジット、Starterは月30,000クレジット、Creatorは月121,000クレジットなど、プランごとに利用可能なクレジット量が異なります。
また、使用モデルによって文字あたりのクレジット消費も変わります。Multilingual v2は基本的に1文字あたり1クレジット、Flash/Turbo系はAPI利用時により低いクレジット消費になる場合があります。
Webアプリに組み込むと、この違いが効いてきます。ユーザーがAIへ質問するたびに回答全文を自動で音声化すると、使われない音声まで毎回生成することになります。アプリでは「1ユーザーが何回押すか」「何文字生成されるか」「何人が使うか」が、そのまま運用コストになります。
最終的に「常時生成」をやめた理由
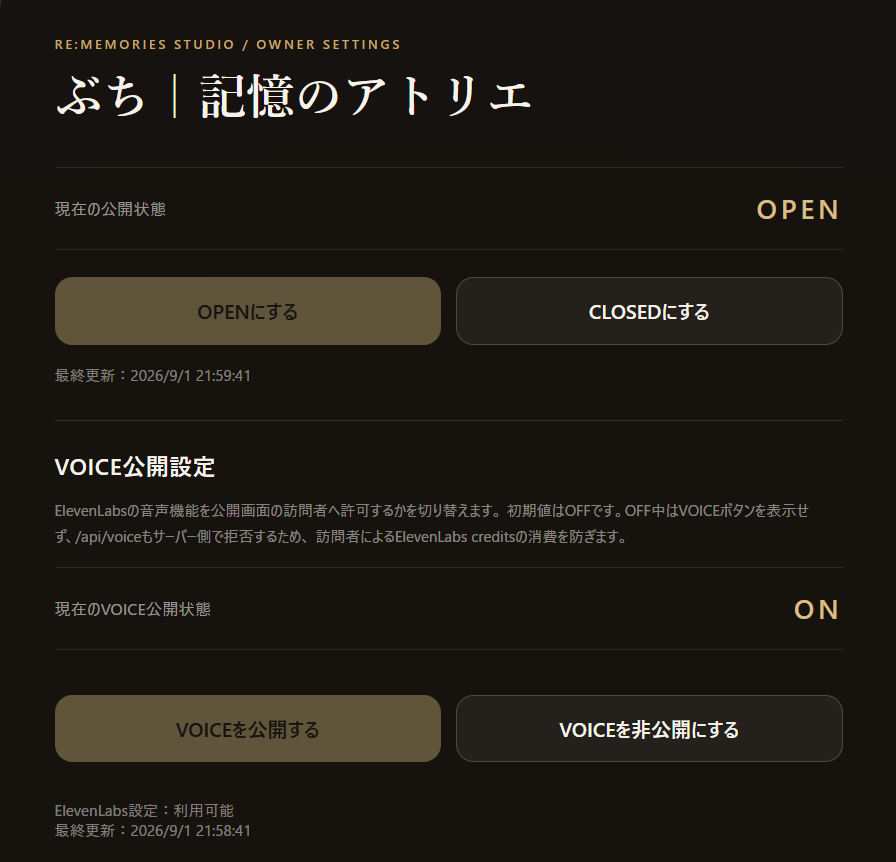
実装を進めた結果、私は音声生成のUX自体を変更しました。毎回答を自動的に音声化するのではなく、回答後に「声で聞く」というボタンを出し、ユーザーが聞きたいときだけElevenLabsへ音声生成を要求するオンデマンド方式にしました。
1. 不要なクレジットを使わない
テキストだけ読むユーザーの回答まで音声化する必要がありません。
2. 画面の応答を音声生成に依存させない
AIの回答表示と音声生成を切り離すことで、ユーザーは先にテキストを読めます。
3. 音声が必要な場面だけ価値を出せる
「聞きたい回答」「感情を乗せて聞きたい文章」だけ音声化する方が、ElevenLabsの品質を活かしやすくなります。
この経験から、ElevenLabsをAPI導入する際は「どのモデルを使うか」より先に、「どの瞬間だけ音声を生成するか」を決めた方がいいと考えるようになりました。
ElevenLabsはどんな人に向いている?
実際に使った範囲では、YouTubeやSNS動画のナレーション、オーディオブックや長文コンテンツ、キャラクター音声、多言語コンテンツ、AIアプリのオンデマンド音声、リアルタイム性を重視する音声AIとは相性が良いと感じます。
一方、固有名詞や難読語を大量に扱う、日本語の読み間違いをほぼゼロにする必要がある、大量の文章を常時API生成する、1文字単位の発音やアクセントを厳密に固定したい、といった条件では事前検証をおすすめします。
ElevenLabsの品質は高いですが、「自然なAI音声」と「運用しやすい日本語音声」は同じ意味ではありません。
料金はどのプランから考えるべき?
2026年9月時点のElevenCreative月額プランでは、公式料金ページに以下が掲載されています。
| プラン | 月額 | 月間クレジット | 主な位置付け |
|---|---|---|---|
| Free | $0 | 10,000 | 試用・個人テスト |
| Starter | $6 | 30,000 | 商用ライセンス、Instant Voice Cloneなど |
| Creator | $22 | 121,000 | より継続的な制作 |
| Pro | $99 | 600,000 | 大量生成 |
| Scale | $299 | 1,800,000 | チーム・高ボリューム |
| Business | $990 | 6,000,000 | 大規模ビジネス |
料金は変更される可能性があるため、契約前に必ず公式ページで最新情報を確認してください。個人が試すだけならFreeから確認できます。ただし商用利用ではStarter以上の条件が関係するため、「無料で音が出たからそのまま商用利用できる」とは考えない方が安全です。
私なら、まず無料枠でVoiceと日本語の読みを確認し、実際に使う文字量が見えてから有料プランを選びます。
まとめ:ElevenLabsは「音質」より運用設計で差が出る
ElevenLabsを日本語AIアプリに実装して一番強く感じたのは、サービス選定を音質だけで決めてはいけないということです。
Eleven v3の表現力、Multilingual v2の安定感、Flash v2.5の速度とコスト効率には、それぞれ明確な使いどころがあります。その一方で、日本語では誤読やイントネーションの問題があり、API利用ではクレジット消費も無視できません。
私自身、最終的には「毎回生成する」設計から「聞きたいときだけ生成する」設計へ変更しました。これはElevenLabsが悪かったからではありません。むしろ、高品質な音声を本当に価値が出る瞬間にだけ使う方が、サービスの長所を活かせると判断したからです。
ElevenLabsを検討しているなら、まず無料枠で自分が実際に使う日本語を入力して、Voice・モデル・誤読・生成量を確認してください。そのうえで、自分の用途が「高品質な音声にお金を払う価値がある場面」なのかを判断するのが一番失敗しにくいと思います。